① 변경일: 2026년 10월 30일 시행 예정(복수 보도 기준). 메타 약관 원문은 이 글 작성 시점에 직접 열람하지 못해 2차 보도와 메타 공식 개발자 문서를 구분해 표기했습니다.
② 메타 공식 크롤러 문서에는 UA 5종(FacebookExternalHit·Meta-WebIndexer·Meta-ExternalAds·Meta-ExternalAgent·Meta-ExternalFetcher)이 있고, 이 중 robots.txt로 제어되는 것과 우회될 수 있다고 적힌 것이 갈립니다.
③ 내 서버 로그에서 UA별 요청 수와 IP 대조 결과를 먼저 보면, 약관 논의와 별개로 방문 지표가 섞이는지 확인할 수 있습니다.
1. 무엇이 바뀌나 — 확인된 것과 확인되지 않은 것
2026년 10월 중순부터 메타의 상업 약관(Commercial Terms) 미리보기에 웹사이트 수집 관련 문구가 들어갔다는 분석이 여러 매체에서 나왔습니다. 약관은 법률 문서라 해석을 단정하면 위험하므로, 아래 표는 “무엇이 어디까지 확인됐는지”를 분리했습니다.
| 항목 | 보도된 내용 | 확인 수준 |
|---|---|---|
| 시행일 | 2026년 10월 30일 | PPC Land·Relevant Audience 등 복수 2차 보도가 메타 약관 미리보기를 인용 |
| 조항 위치 | “Licences and rights you provide Meta” 섹션에 단락 추가 | 2차 보도. 메타 약관 페이지는 자동 열람이 차단되어 원문 직접 확인 불가 |
| 첫 문장 | 메타(또는 대리 주체)가 자동화 소프트웨어로 사업 제품·서비스 관련 도메인·페이지에 접근·수집하고, 테스트 자격 증명을 만들고, 주기적으로 업데이트를 가져올 수 있다 | 2차 보도(인용문 일치) |
| 둘째 문장 | 해당 페이지의 콘텐츠를 제품 제공·개발·개선·연구·학습에 쓸 수 있다는 취지 | 10/18 PPC Land는 미리보기에 그대로 있다고 확인, 10/17 The Verge는 삭제됐다고 보도 → 상충 |
| 적용 범위 | 메타 대변인은 수집 조항이 광고·비즈니스 제품에 한정된다고 설명했다고 보도 | 대변인 발언 인용. 약관 문구에 한정 표현이 있는지는 미확인 |
| 선택권 | 부분 거부 없음, 개정 후 계속 사용하면 동의로 간주 | 2차 보도 기준 |
| robots.txt | 조항 문구 자체에는 언급 없음. 메타 측은 robots.txt로 접근을 관리할 수 있다고 말했다고 보도 | 2차 보도 |
※ 출처 한계: 약관 본문(facebook.com/legal)은 이 글을 작성한 도구로 열 수 없어 직접 확인하지 못했습니다. 시행 전에 약관 원문을 직접 열어 문구를 확인하고, 법적 해석은 법무 담당자와 검토하십시오. 이 글은 법률 자문이 아닙니다.
2. 메타 크롤러 5종 — 공식 문서 기준 사양
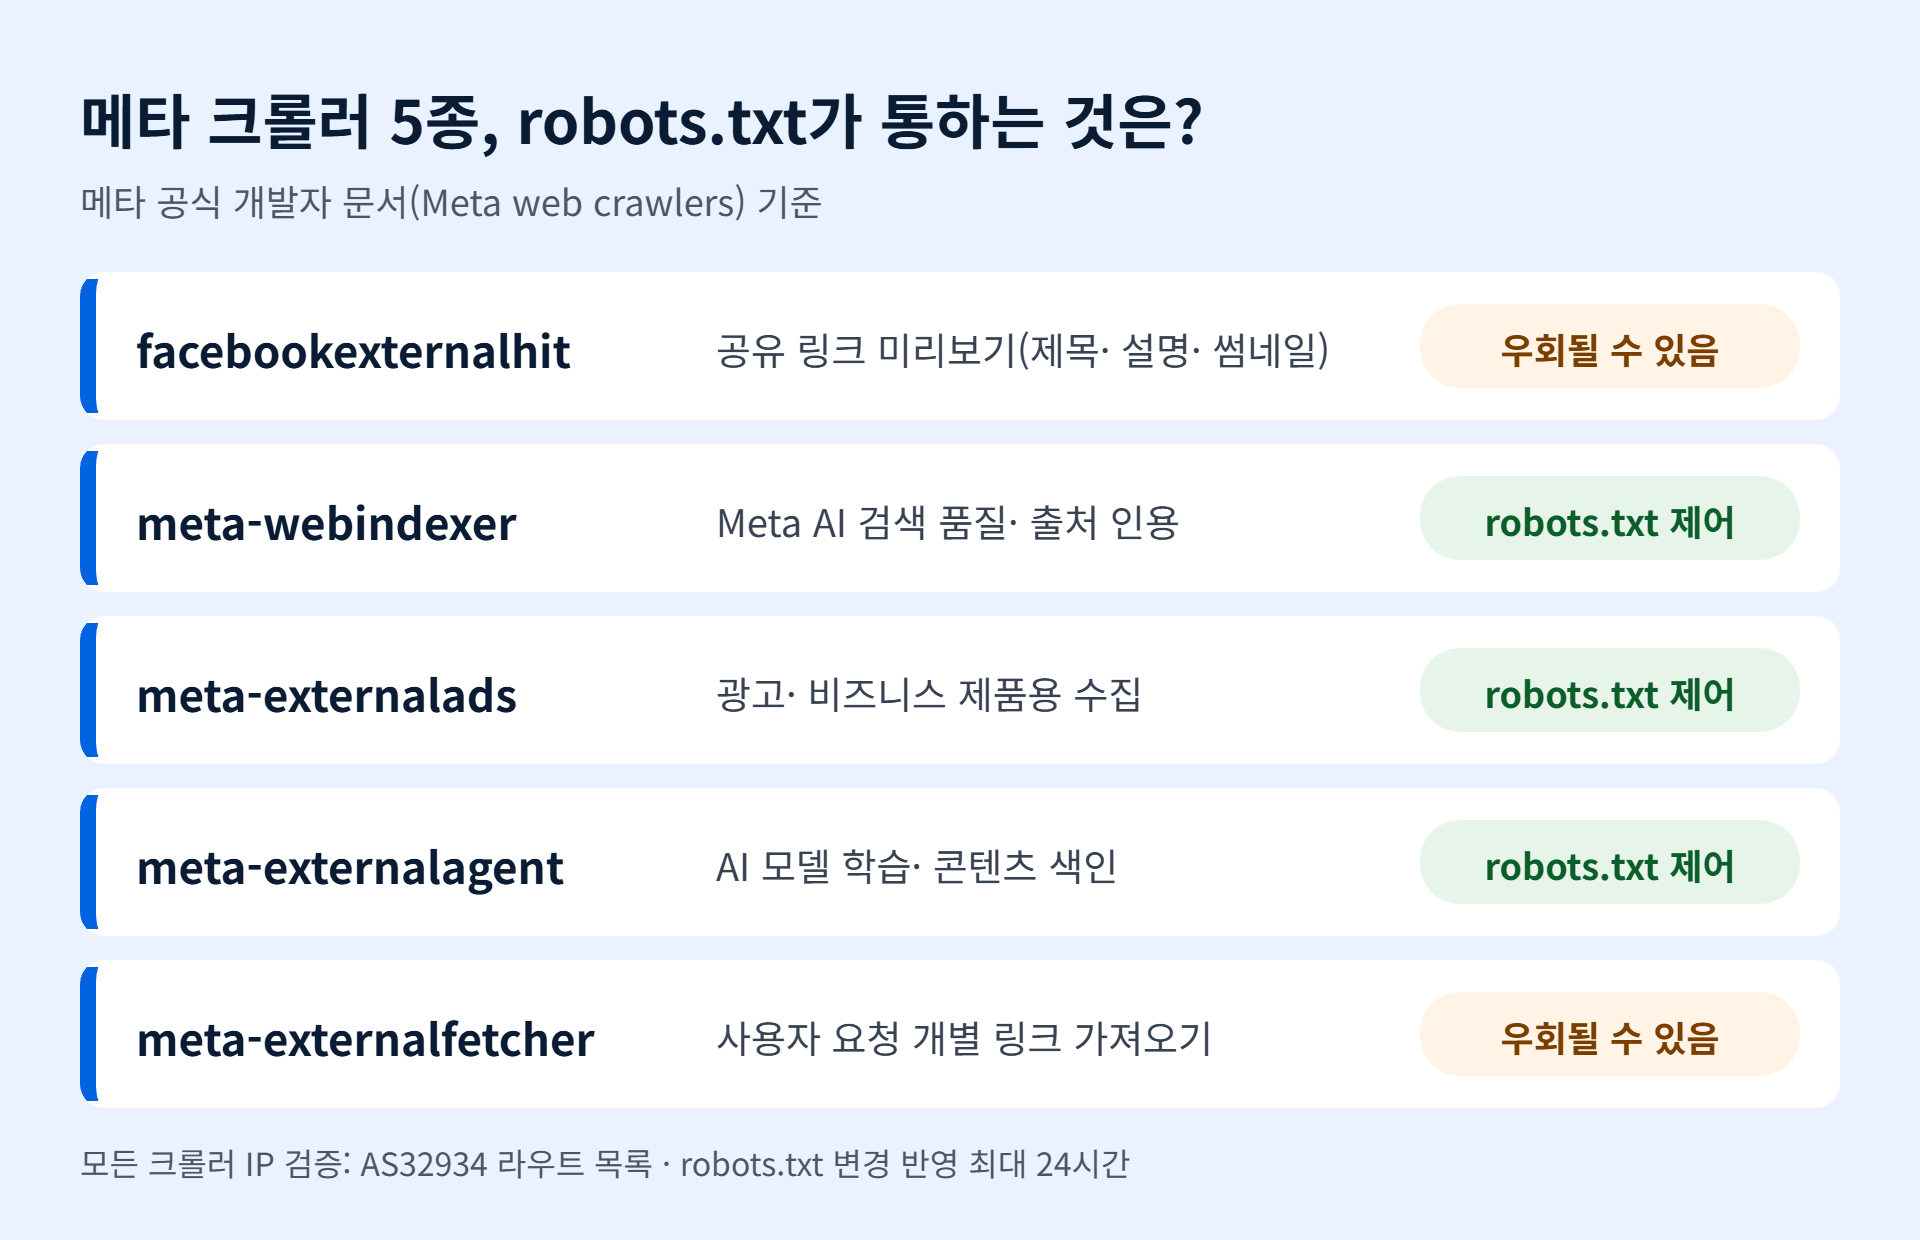
아래 표는 메타 개발자 문서(Meta web crawlers)에 나온 내용입니다. 약관 논의와 달리 이 부분은 1차 출처입니다. 핵심은 “robots.txt로 제어된다”고 적힌 크롤러와 “우회할 수 있다”고 적힌 크롤러가 다르다는 점입니다.
| 크롤러(UA 토큰) | 수집 목적(공식 문서 표현) | robots.txt | 사이트에서 볼 때 |
|---|---|---|---|
| facebookexternalhit | Meta 앱에서 공유된 링크의 제목·설명·썸네일을 가져와 캐시 | 보안·무결성 점검 시 우회할 수 있다고 명시 | 공유 미리보기용. 막기 전 미리보기 영향 확인 필요 |
| meta-webindexer | Meta AI 검색 품질 개선, 답변에서 출처 인용·링크 | robots.txt로 제어 | 허용 시 출처 링크 인용 가능성이 문서에 언급됨 |
| meta-externalads | 광고 및 기타 비즈니스 제품·서비스용 수집 | robots.txt로 제어(Disallow로 차단) | 광고 집행에 미치는 영향은 문서에 명시 없음 → 테스트 필요 |
| meta-externalagent | 파운데이션 AI 모델 학습, 콘텐츠를 직접 색인해 제품 개선 | robots.txt로 제어(Disallow로 차단) | AI 학습 목적 수집 제한 시 우선 검토 대상 |
| meta-externalfetcher | 사용자 요청에 따라 개별 링크를 가져와 에이전트형 AI 기능 지원 | 사용자 요청 기반이라 우회할 수 있다고 명시 | robots.txt 규칙이 안 먹어도 문서상으로는 정상 |
※ 공식 문서 기준 모든 크롤러는 AS32934 라우트 목록으로 IP를 검증할 수 있고, robots.txt 변경은 크롤러가 파일을 캐시해 반영까지 최대 24시간이 걸릴 수 있다고 안내합니다.
3. 내 서버가 지금 받는 요청 확인하기 — 로그 집계와 IP 대조
UA 문자열은 누구나 흉내 낼 수 있으므로, 토큰별 요청 수와 메타 소유 IP 대역과의 일치 여부를 같이 봐야 합니다. 먼저 UA 토큰별로 세고, 이어서 IP를 대조합니다.
# nginx combined 로그 기준 — UA 토큰별 요청 수
LOG=/var/log/nginx/access.log
for ua in facebookexternalhit meta-webindexer meta-externalads meta-externalagent meta-externalfetcher; do
  printf "%-24s %s\n" "$ua" "$(grep -ic "$ua" "$LOG")"
done

# 특정 크롤러가 어느 URL을 얼마나 가져갔는지 (상위 20)
grep -i "meta-externalagent" "$LOG" | awk '{print $7}' | sort | uniq -c | sort -rn | head -20

# 메타 소유 라우트 목록 (공식 문서의 검증 명령, 목록은 자주 바뀌므로 정기 갱신)
whois -h whois.radb.net -- '-i origin AS32934' | grep ^route > meta_routes.txt
import ipaddress, re, collections
TOKENS = ["facebookexternalhit", "meta-webindexer", "meta-externalads",
"meta-externalagent", "meta-externalfetcher"]
# meta_routes.txt 한 줄 예: "route: 31.13.24.0/21" (route6 도 포함)
nets = [ipaddress.ip_network(l.split()[1]) for l in open("meta_routes.txt") if l.startswith("route")]
cache = {}
def is_meta(ip):
if ip not in cache:
a = ipaddress.ip_address(ip)
cache[ip] = any(a in n for n in nets if n.version == a.version)
return cache[ip]
rx = re.compile(r'^(\S+) .*"([^"]*)"\s*$') # 첫 필드=클라이언트 IP, 마지막 따옴표=UA
cnt = collections.Counter()
for line in open("access.log", errors="replace"):
m = rx.match(line)
if not m:
continue
ip, ua = m.groups()
low = ua.lower()
for t in TOKENS:
if t in low:
cnt[(t, "meta_ip" if is_meta(ip) else "ua_only")] += 1
break
for k, v in sorted(cnt.items()):
print(k, v)※ CDN·로드밸런서 뒤에 있으면 로그 첫 필드가 CDN IP일 수 있습니다. 이 경우 X-Forwarded-For 등 실제 클라이언트 IP 필드로 바꿔 대조해야 결과가 맞습니다. 그리고 “ua_only”는 위장이라고 단정할 수 없고, IP 목록이 오래됐거나 중간 프록시일 가능성도 함께 봐야 합니다.
4. robots.txt 설계 — 막을 것과 둘 것
어떤 크롤러를 허용할지는 사업 판단입니다. 아래는 문서에 적힌 제어 범위를 반영한 예시 구조이며, 그대로 복사해 쓰라는 뜻이 아닙니다.
# 예시 — 정책에 맞게 조정할 것
# (1) AI 모델 학습 목적으로 문서화된 수집기: 전체 제한
User-agent: meta-externalagent
Disallow: /

# (2) 광고·비즈니스 제품용 수집기: 영향 확인 전에는 비공개 경로만 제한
User-agent: meta-externalads
Disallow: /private/
Disallow: /admin/

# (3) Meta AI 검색 인용용: 허용하면 출처 링크 인용 가능성
User-agent: meta-webindexer
Allow: /

# facebookexternalhit, meta-externalfetcher 는 문서상 우회될 수 있어
# robots.txt 규칙만으로 차단된다고 가정하지 말 것- robots.txt 응답부터 확인 — /robots.txt가 HTTP 200, text/plain으로 응답하는지. 5xx나 리다이렉트 체인이면 크롤러가 규칙을 못 읽을 수 있습니다.
- 차단 전 영향 테스트 — meta-externalads를 막으면 광고 심사나 카탈로그 수집에 영향이 있는지는 공개 문서에 없습니다. 트래픽이 적은 경로부터 적용하고 광고 관리자 알림을 확인하십시오.
- 반영 대기 — 문서상 최대 24시간. 변경 직후 로그가 그대로여도 정상입니다.
- 정책과 약관의 관계는 별도 — robots.txt는 접근 규칙이고, 약관상 허락 범위가 어떻게 되는지는 법무 검토 사항입니다.
5. 계산으로 확인 — 크롤러 요청이 방문 수에 섞이면 캠페인 순위가 뒤집힌다
서버 로그나 분석 도구의 “방문” 수를 광고 효율 판단에 쓰는 팀이라면 크롤러 요청의 비중이 캠페인별로 다를 때 결론이 바뀔 수 있습니다. 아래는 설명용 가정값이며 실제 계정 수치가 아닙니다.
| 항목 | 캠페인 A | 캠페인 B |
|---|---|---|
| 월 광고비 | 1,000만원 | 1,000만원 |
| 로그 기준 방문 수 | 4,000 | 3,200 |
| 방문당 비용 (로그 기준) | 2,500원 (A 우세) | 3,125원 |
| 크롤러 UA 요청(가정) | 1,500 (37.5%) | 200 (6.25%) |
| 사람 방문 수 (크롤러 제외) | 2,500 | 3,000 |
| 방문당 비용 (크롤러 제외) | 4,000원 | 3,333원 (B 1.2배 우세) |
로그 그대로 보면 A가 25% 싸 보이지만, 크롤러 요청을 걷어내면 B가 약 1.2배 효율적입니다. 로그 기준 판단대로 B 예산 500만원을 A로 옮기면, 단순 선형 가정에서 사람 방문은 5,500에서 5,250으로 월 250, 연 3,000 줄어듭니다(A 1,500만원 × 0.00025 = 3,750 + B 500만원 × 0.0003 = 1,500).
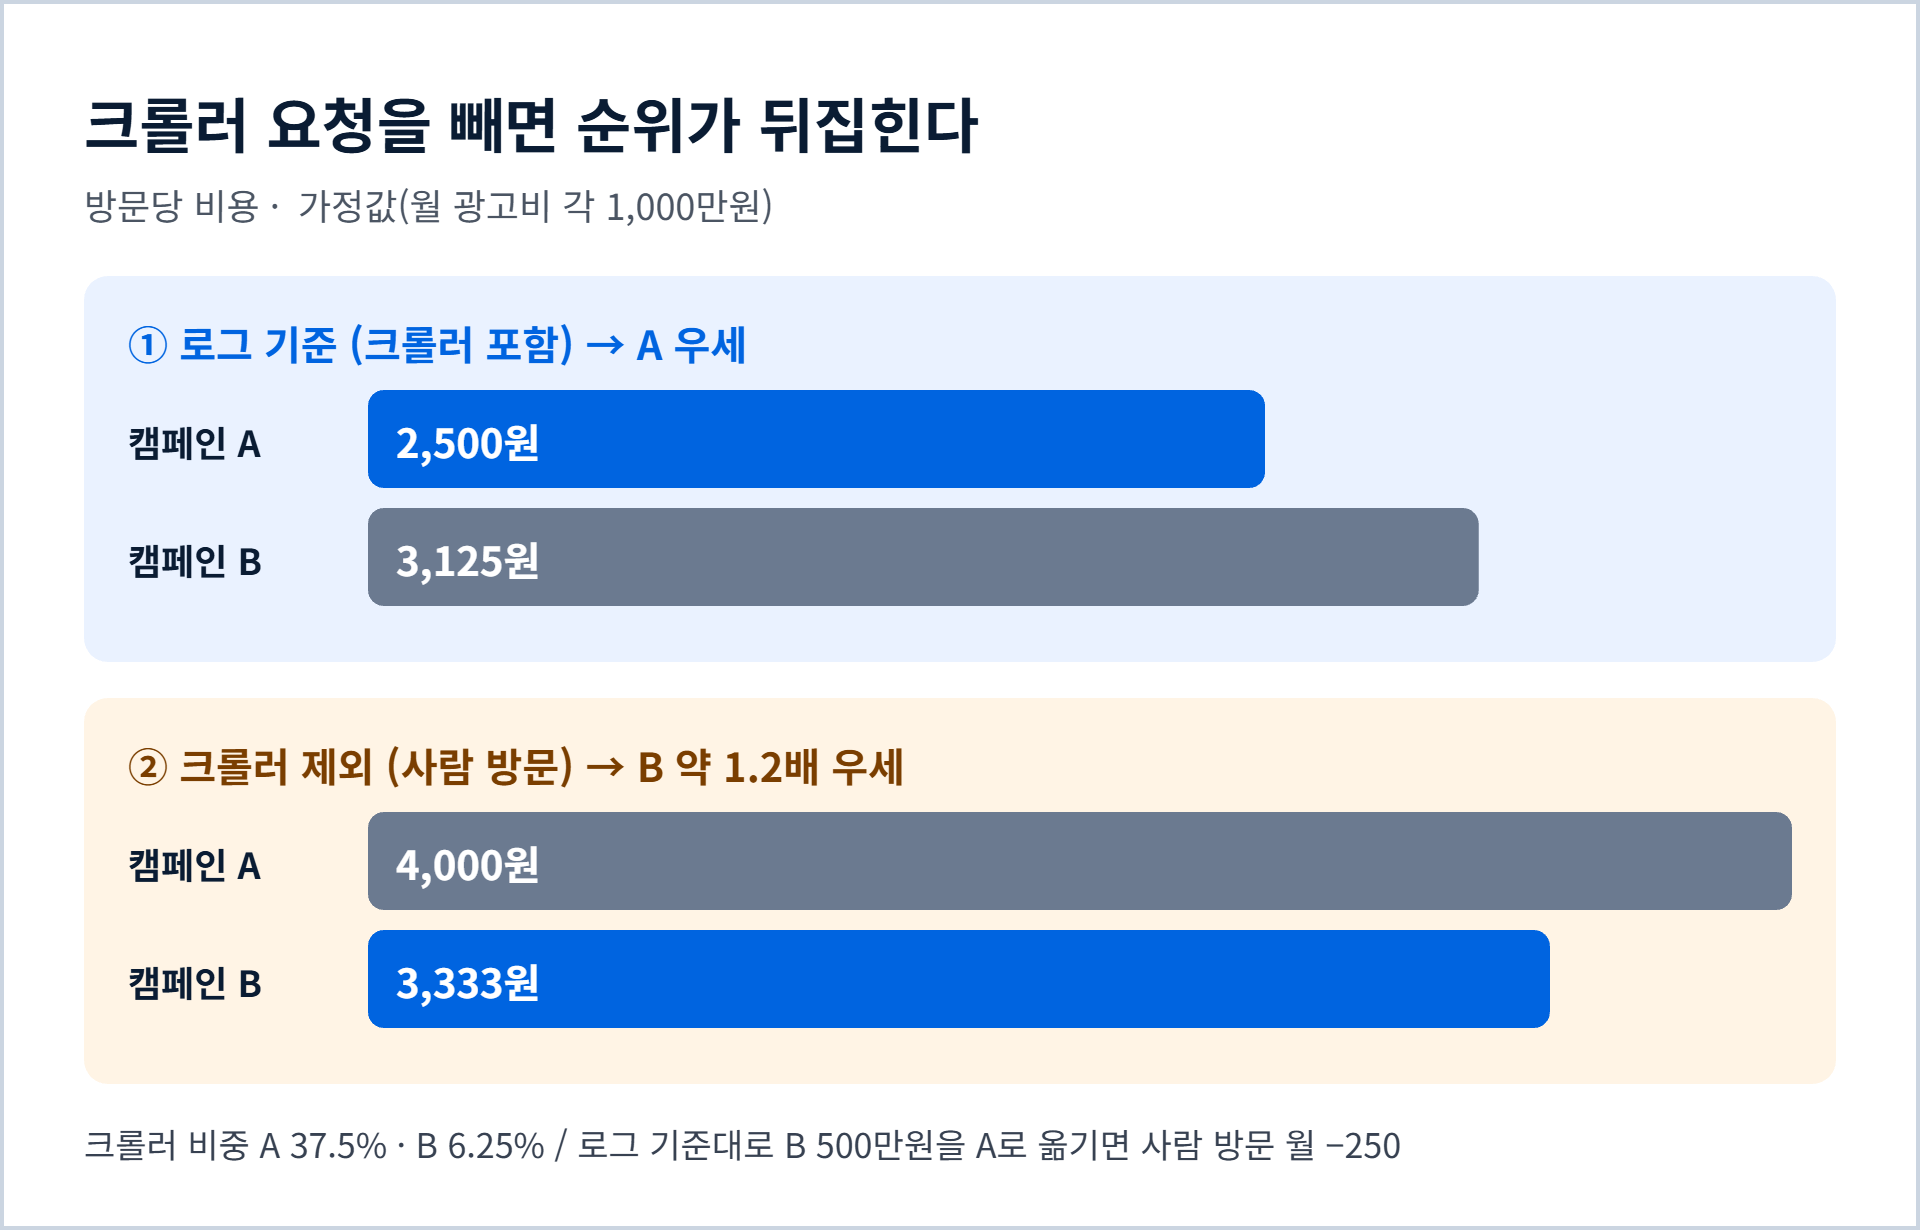
※ 가정: 광고 클릭 대신 서버 로그 방문을 효율 지표로 쓰는 경우, 메타 크롤러가 캠페인 랜딩 URL을 비대칭적으로 가져가는 상황. 실제 비대칭 여부는 3장의 로그 집계로 확인해야 합니다.
6. 5단계 검증 절차 — 무엇이 정상인가
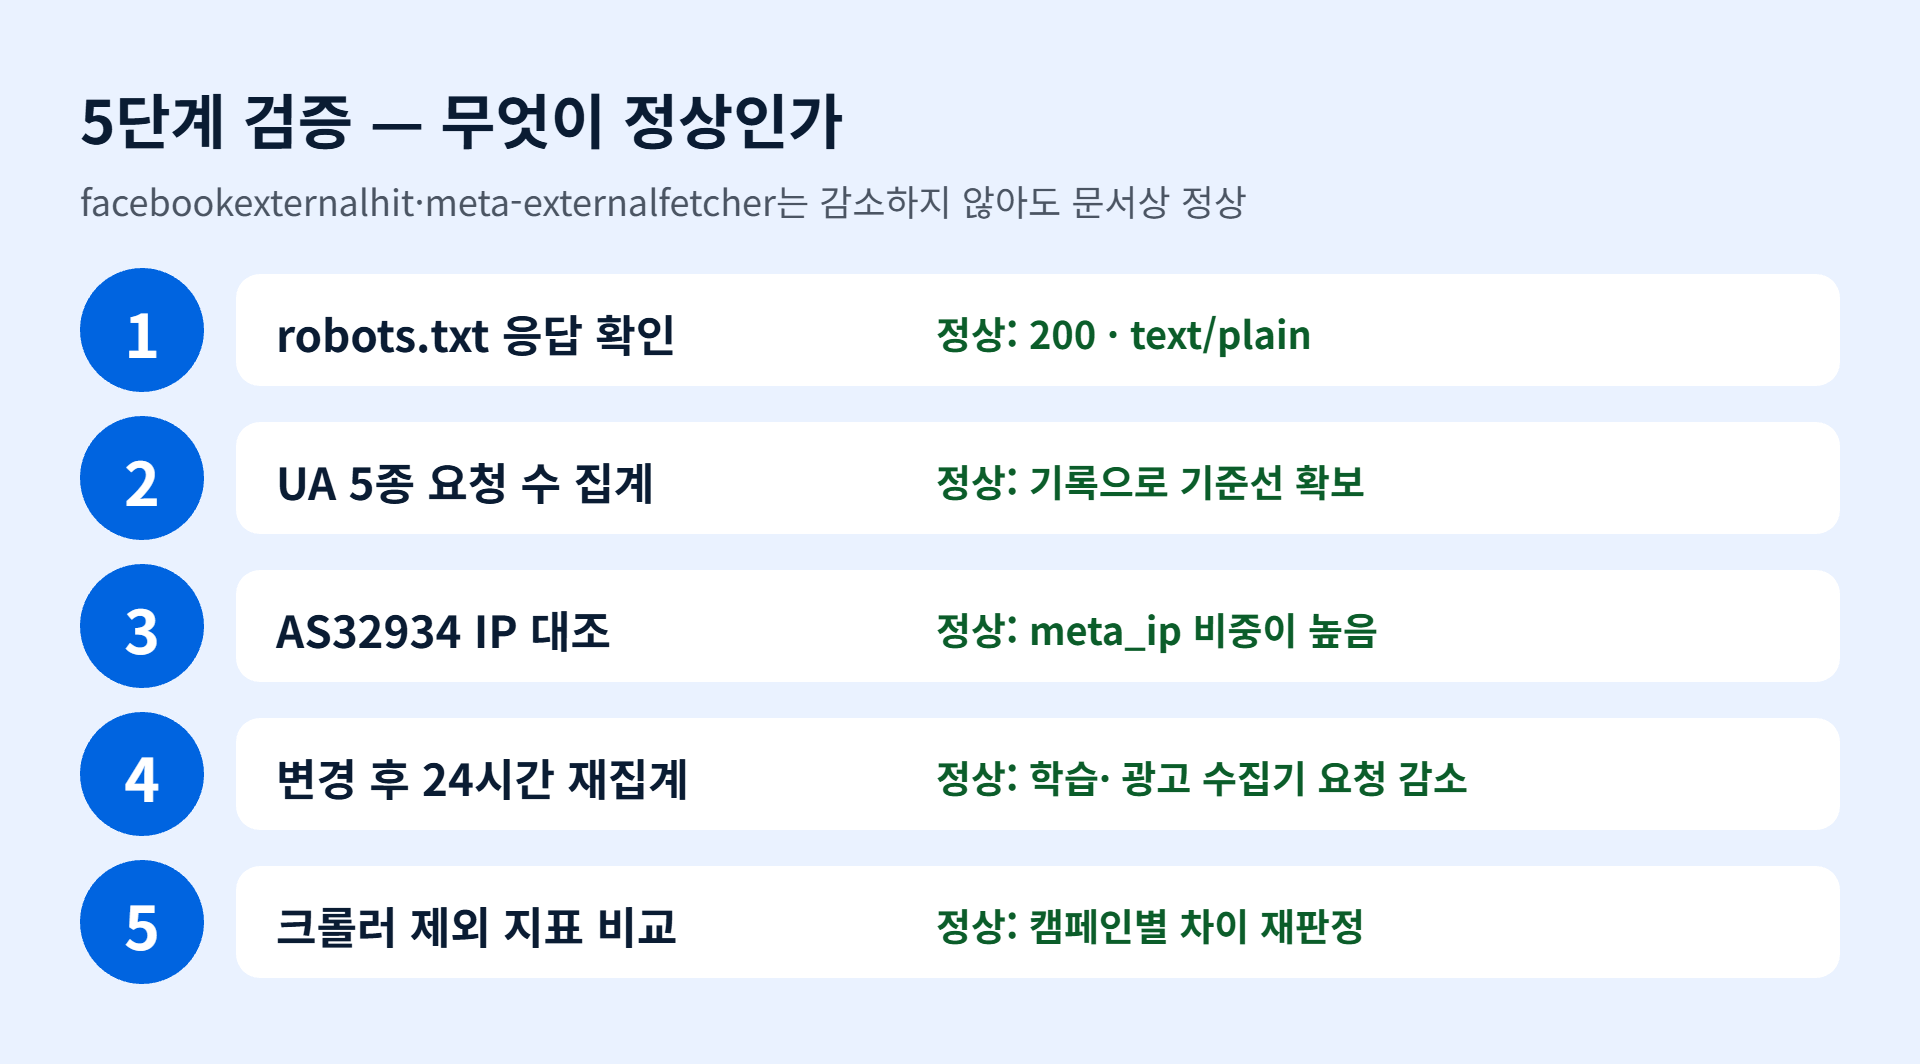
| 단계 | 할 일 | 정상 기준 |
|---|---|---|
| 1 | /robots.txt 현재 내용 저장, 응답 코드·Content-Type 확인 | 200, text/plain, 의도한 규칙이 그대로 있음 |
| 2 | 로그에서 UA 토큰 5종별 요청 수 집계(최근 7일·30일) | 수치가 기록으로 남아 변경 전후 비교가 가능 |
| 3 | AS32934 라우트 목록과 IP 대조 | meta_ip 비중이 높고 ua_only는 소수. ua_only가 많으면 프록시·목록 시점 확인 |
| 4 | robots.txt 변경 후 24시간 이상 지나 재집계 | meta-externalagent·meta-externalads 요청 감소. facebookexternalhit·meta-externalfetcher는 감소하지 않아도 문서상 정상 |
| 5 | 방문·세션 지표에서 크롤러 UA를 제외한 값과 비교 | 제외 전후 차이가 캠페인별로 비슷하면 순위 영향 없음, 다르면 5장 계산처럼 재판정 |
7. 시행 전 대응 체크리스트
- 메타 상업 약관·셀프서브 광고 약관의 시행일 문서를 직접 열어 문구를 확인하고 날짜를 기록한다.
- 법무 담당자에게 “사업 제품·서비스와 연결된 웹페이지 수집” 조항의 범위와 robots.txt의 관계를 검토 요청한다.
- 현재 robots.txt와 서버 로그의 메타 크롤러 UA 집계를 10월 30일 이전에 저장해 기준선을 만든다.
- 정책이 정해지면 robots.txt를 단계 적용하고, 24시간 후 재집계로 효과를 확인한다.
- 방문·세션 기반 효율 지표는 크롤러 UA 제외 값을 함께 보고하도록 리포트 정의를 정리한다. 지표 정합성은 퍼포먼스마케팅 지표 불일치 글과, 증분성 검증은 증분성 측정 글과 함께 보면 좋습니다.
- 같은 시기 일정이 몰려 있습니다: 10월 28일 상품 둘러보기, 10월 27일 마케팅 API 변경과 함께 한 번에 점검 일정을 잡으십시오.
자주 묻는 질문
Q. meta-externalagent를 robots.txt로 막으면 광고 집행에 문제가 생기나요?
공개된 메타 크롤러 문서에는 이 크롤러를 막았을 때 광고 집행에 불이익이 있다는 안내가 없습니다. 다만 약관 문구와 별개이므로, 막은 뒤 광고 관리자 알림과 심사 상태를 일정 기간 확인하십시오.
Q. 개정 약관에 동의하지 않으면 어떻게 되나요?
보도에 따르면 부분 거부 선택지는 없고, 개정 이후 계속 사용하면 동의로 간주됩니다. 이 부분이 계정별로 어떻게 적용되는지는 약관 원문과 법무 검토로 확인해야 합니다.
Q. facebookexternalhit까지 막으면 되나요?
공식 문서상 이 크롤러는 공유된 링크의 제목·설명·썸네일을 가져오는 용도이며, 보안·무결성 점검 시 robots.txt를 우회할 수 있다고 적혀 있습니다. 막는다고 가정하기 전에 링크 공유 미리보기에 미치는 영향을 먼저 확인하십시오.
Q. IP 목록은 얼마나 자주 갱신해야 하나요?
메타는 해당 IP가 자주 바뀐다고 안내합니다. 대조 스크립트를 쓸 때마다 라우트 목록을 새로 받는 방식이 안전합니다.
Q. 로그가 없는 호스팅 환경이라면?
접근 로그를 제공하는 호스팅이나 CDN 로그 기능을 켜야 위 절차를 쓸 수 있습니다. 로그 보존 기간이 짧으면 10월 30일 이전 기준선을 먼저 내려받아 두십시오.
마치며
이번 개정의 해석은 약관 원문과 법무 검토의 몫이지만, 내 사이트가 지금 메타 크롤러에게 어떤 요청을 받는지는 서버 로그로 오늘 확인할 수 있습니다. 시행일인 10월 30일 전에 UA 집계와 IP 대조로 기준선을 저장하고, robots.txt는 크롤러별 제어 범위를 감안해 단계적으로 바꾼 뒤 24시간 후 재집계로 확인하십시오.
관련 글: SEO·GEO 체크리스트 — AI 인용 5단 점검 · 광고주 담당자 책임범위
대표번호 02-501-1451 · marketing2@inobean.com